想把手里的录音、网课、采访音频变成带时间戳的字幕文件,网上的「语音识别工具」大多绕不开两条路:要么联网上传音频到云端(隐私和额度都悬),要么装一套 Python 环境敲命令行。这次实测的 Whisper Desktop 是 OpenAI 开源语音识别模型 Whisper 的 Windows 桌面版:免费开源、完全离线运行,程序本体只有 0.5MB,界面点两下就能把音频转成 SRT 字幕。本站实测了「装模型 → 英文转写 → 中文转写 → 实时麦克风识别」全流程,17 秒英文音频约 2.6 秒出全部字幕,下面的截图和识别结果全部来自本次实测。
下载地址
三个网盘提取码均为 8888。程序包 WhisperDesktop.zip 只有 465.65 KB,版本 1.12.0,Windows 64 位;base 模型 ggml-base.bin 为 141.1 MB,蓝奏云单文件上限 100MB 放不下,所以模型只传了 123 和夸克。
模型和程序是分开的:zip 解压得到 WhisperDesktop.exe(332KB)和 Whisper.dll(576KB),首次启动会让你指定一个 GGML 格式的模型文件。模型官方托管在 Hugging Face,国内直连经常打不开(实测 huggingface.co 直连超时),所以本站把最常用的 base 多语言模型传到了网盘,下载后直接选用即可。
实测信息
- 下载来源:GitHub 官方仓库 Const-me/Whisper 的 v1.12.0 release(2023-07-22 发布),约 10.7k Star,MPL-2.0 协议
- 程序包:476,830 字节(465.65 KB),zip 解压即用,免安装、不需要登录、不写注册表也能跑
- 模型:ggml-base.bin(多语言版),147,951,465 字节(141.1 MB),程序内显示「141.1 MB on disk, GPU」
- 实测机器:AMD Radeon 核显(DirectX 11),GPU 实现正常加载
- 实测音频:Windows 自带 TTS 生成的英文 17 秒、中文 12 秒、英文长录音 34 秒,全部转写成功
首次启动:选一个模型就能用
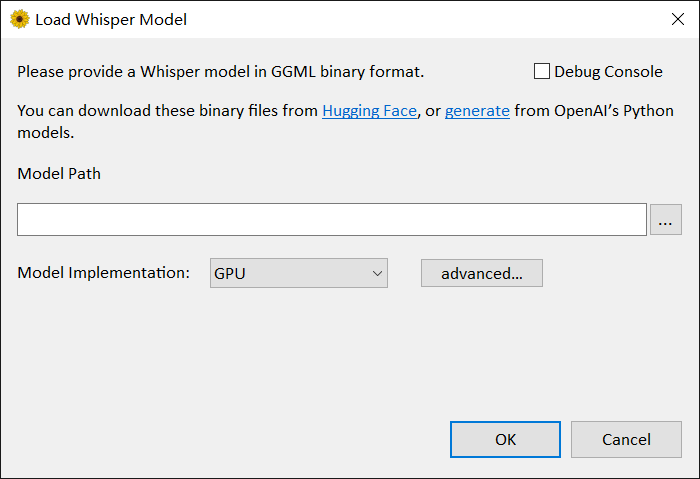
程序第一次打开是「Load Whisper Model」窗口:可以把本地 GGML 模型文件的路径填进去(点「...」浏览选择),也可以勾选从 Hugging Face 在线下载。选好模型点 OK,主界面顶部会显示模型信息——实测显示 Multilingual model "ggml-base.bin", 141.1 MB on disk, GPU,说明 GPU 加速已经生效。
文件转写:选音频、选格式、点一下
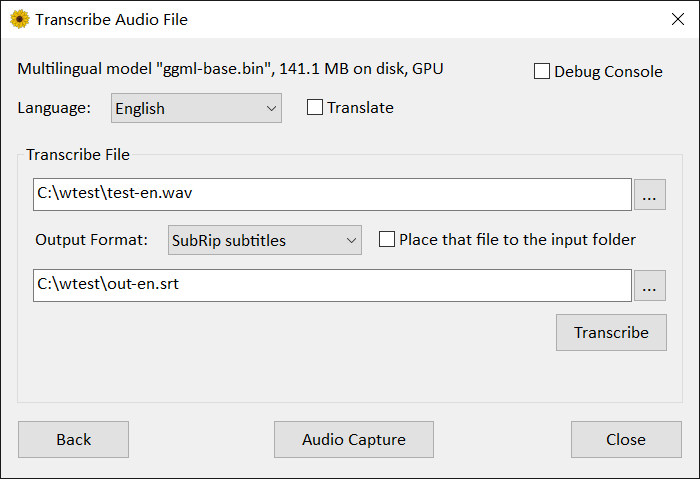
主界面就三步:Language 下拉选语言(支持多语言,也可以让它自动检测)、Transcribe File 里选音频文件、Output Format 选输出格式。输出格式有 None / Text file / Text with timestamps / SubRip subtitles / WebVTT subtitles 五种,做字幕选 SubRip 就是标准 .srt 文件。点 Transcribe 按钮,进度条跑完就能拿到带时间戳的字幕。
实测 17 秒英文音频(TTS 生成,内容是介绍这款工具的普通话速英文),从点击到转写完成约 2.6 秒,输出的 SRT 时间轴准确、断句合理:
1
00:00:00,000 --> 00:00:06,880
Hello everyone. Today we are testing Whisper Desktop, a free and open source
speech recognition tool.

2
00:00:06,880 --> 00:00:13,760
It runs completely offline on your own computer, powered by a DXGPU accelerated engine.
(原文说的是 DirectX GPU,base 模型听成了 DXGPU——这是小模型的正常水平,换 medium 模型会明显更准。)
中文转写:多语言模型直接识别
把 Language 切到 Chinese、换一段 12 秒的中文 TTS 录音再跑,约 2.7 秒完成。识别结果准确,但 base 模型输出的是繁体中文(Whisper 小模型的常见现象),做简体字幕建议换 small 或 medium 模型,或者用文本工具做一次繁简转换:
1
00:00:00,000 --> 00:00:04,000
大家好,今天我們測試語音轉文字工具。

2
00:00:04,000 --> 00:00:12,200
它完全離線運行,不上傳任何音頻到雲端,可以自動識別中文和英文。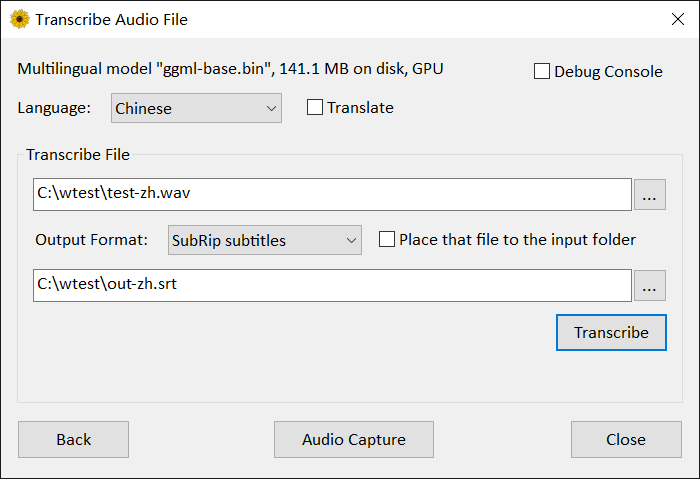
又用 34 秒的英文长录音(六句话)压了一遍速度:点击 Transcribe 后约 3 秒,六段带时间戳的 SRT 全部就位,识别内容与原文逐句一致。整个推理过程在本机 GPU 上跑,全程断网也能工作。
实时转写:麦克风说话直接出字
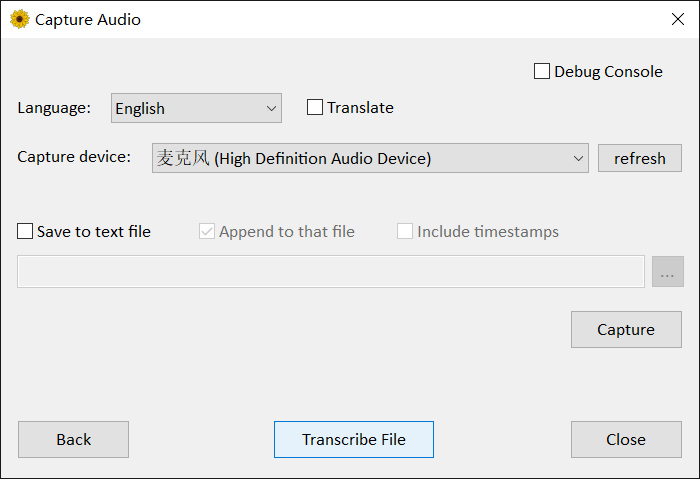
主界面底部的 Audio Capture 是另一个玩法:不走文件,直接选麦克风实时识别。实测页面能正确列出本机录音设备(麦克风 High Definition Audio Device),支持保存到文本文件、追加写入和带时间戳三种选项,开会记录、直播字幕这类场景够用。
模型怎么选(体积与效果)
Whisper 模型按参数量分档,都是 GGML 单文件,放在任意目录后在程序里指定路径即可:
- tiny / base(约 75MB / 142MB):速度快到秒出,英文清晰语音够用;base 是速度和效果的平衡点,本站网盘传的就是它
- small(约 466MB):中文效果明显更好,简体输出更稳,推荐中文用户从这档起步
- medium / large(1.5GB / 3GB 级):接近商用识别精度,速度仍然实时,机器带得动就上
同一模型的 .en 后缀版本是英文专用(更小更准但不识别中文)。模型官方下载在 Hugging Face 的 ggerganov/whisper.cpp 仓库,国内打不开就用本站网盘的 base 模型先跑起来。
实测重点
- 真离线:模型加载后推理全程本地完成,不联网、不上传音频、不需要账号登录
- 免安装:zip 解压双击就能用,0.5MB 的程序本体加一个模型文件就是全部
- 界面是英文的:没有中文界面,但全部操作就是「选模型 → 选音频 → 点按钮」三步,没有理解成本
- 转写速度:实测 17 秒英文音频 2.6 秒、12 秒中文音频 2.7 秒、34 秒长录音约 3 秒(AMD 核显 + base 模型,GPU 实现)
- 输出格式全:纯文本、带时间戳文本、SRT 字幕、WebVTT 字幕四种落盘格式,做视频字幕直接可用
- base 模型中文出繁体:换 small 及以上模型改善,或转写后做繁简转换
- 模型下载器走 Hugging Face:国内网络建议直接用本站网盘的模型文件
软件信息
| 项目 | 内容 |
|---|---|
| 软件名称 | Whisper Desktop(Const-me/Whisper 项目) |
| 当前版本 | 1.12.0(2023-07-22) |
| 软件大小 | 程序包 465.65 KB / base 模型 141.1 MB |
| 系统要求 | Windows 64 位,DirectX 11 显卡 |
| 语言界面 | 英文界面,识别语言支持多语种 |
| 模型格式 | GGML 二进制(whisper.cpp 系) |
| 开源协议 | MPL-2.0,GitHub 约 10.7k Star |
| 是否收费 | 完全免费,开源 |
| 是否需要登录 | 不需要,离线可用 |
关于病毒扫描与包安全
- 本包从 GitHub 官方仓库 Const-me/Whisper 的 v1.12.0 release 直链下载,未经任何第三方修改
- 程序包 SHA-256:
483a82cc93e89c7e8a0187e4809a026d7b797e051bf4f9e54b6268e1fc574c62,模型文件 SHA-256:60ed5bc3dd14eea856493d334349b405782ddcaf0028d4b5df4088345fba2efe,可用命令certutil -hashfile 文件名 SHA256自行比对 - 程序无数字签名(开源项目官方构建),多引擎病毒扫描待补扫,扫完回填本节