LM Studio 是目前最省心的免费本地大模型(Local LLM)客户端:不用装 Python、不用敲命令行,装好后从界面里挑一个 GGUF 模型点 Load,就能在自己的电脑上离线跑 AI 对话;还能一键开一个 OpenAI 兼容的本地 API 服务,把本地模型接进任何支持 ChatGPT 接口的工具里。本站实测了完整的「下载 → 安装 → 放模型 → 对话 → 开 API」流程,下面的截图和数据全部来自本次实测。
下载地址
| 网盘 | 地址 |
|---|---|
| 123 网盘(直传安装包) | 123 网盘下载 |
| 夸克网盘(直传安装包) | 夸克网盘下载 |
| 蓝奏云 第1卷 | part1of7.zip |
| 蓝奏云 第2卷 | part2of7.zip |
| 蓝奏云 第3卷 | part3of7.zip |
| 蓝奏云 第4卷 | part4of7.zip |
| 蓝奏云 第5卷 | part5of7.zip |
| 蓝奏云 第6卷 | part6of7.zip |
| 蓝奏云 第7卷 | part7of7.zip |
三个网盘提取码均为 8888。安装包 LM-Studio-0.4.25-1-x64.exe,588.2 MB,Windows 64 位。
蓝奏云免费账户单文件上限 100MB,装不下这个 588MB 的安装包,所以拆成了 7 个分卷包(每个 zip 里是一个 7-Zip 分卷
LM-Studio-0.4.25-1-x64.7z.001~.007,store 模式直接切开、未做二次压缩)。用法:7 个 zip 全部下载到同一个文件夹 → 逐个解压(解出 7 个 .7z.001~.007 分卷)→ 右键.001那个文件 → 7-Zip → 解压到当前文件夹,即可还原出完整安装包,内容与直传包逐字节一致。嫌麻烦就直接用 123 网盘或夸克的直传包。
实测信息
- 下载来源:lmstudio.ai 官方下载页的重定向直链(installers.lmstudio.ai 官方 CDN),版本 0.4.25 (Build 1)
- 安装包:616,728,536 字节(588.2 MB),NSIS 安装器,支持
/S静默安装 - 数字签名:Valid,
CN=Element Labs Inc.(LM Studio 开发公司),DigiCert 时间戳 - 实测方式:静默安装后无人值守操作,全程截图为证;对话测试用的是 Qwen2.5-0.5B-Instruct(Q4_K_M,491.40 MB)
功能亮点
三步进入主界面,全程不强制注册登录。首启是「Local AI on your computer」欢迎页,点 Get Started 后依次经过模型推荐页和高级设置页(这里可以关掉「登录时启动本地 LLM 服务」的开机自启,见实测重点),不需要任何账号就能一直用。
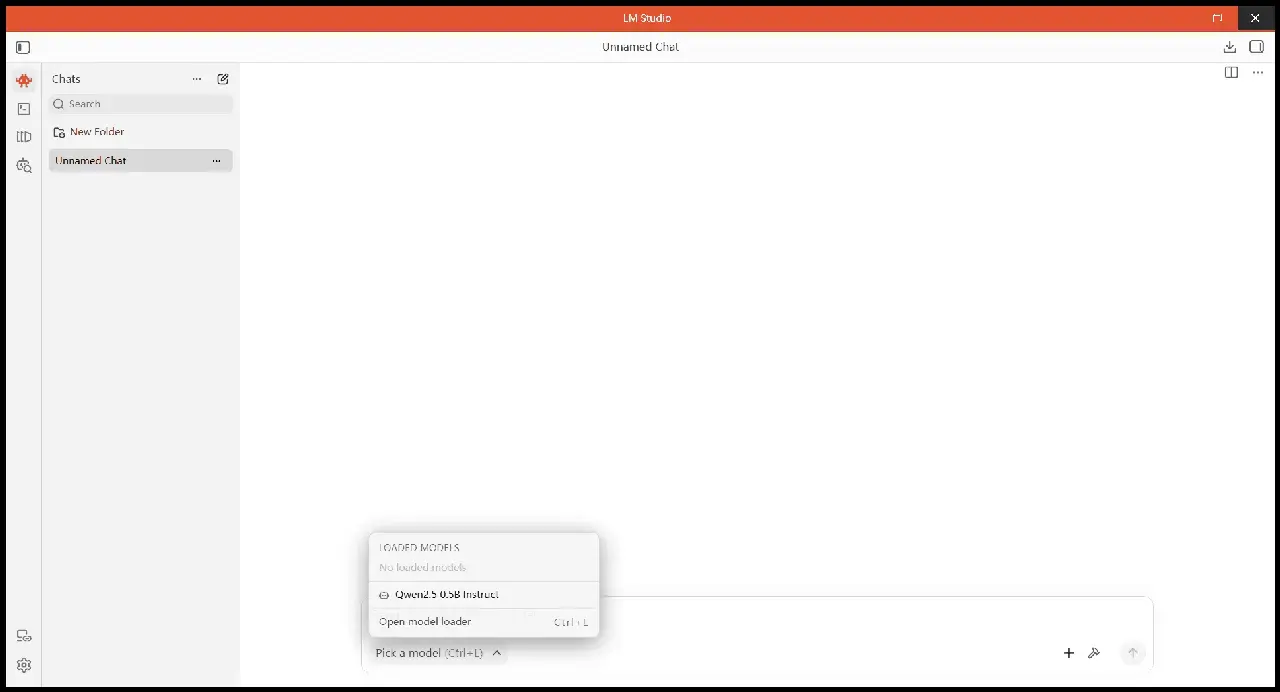
模型库自带推荐,也能放自己下载的模型。引导页会按你的硬件推荐模型(实测推荐了 google/gemma-4-e4b,7.9GB);如果只想先拿个小模型试试水,从本站网盘下载 GGUF 文件扔进模型目录(默认 C:\用户名\.lmstudio\models)也能被自动索引——实测放进一个 Qwen2.5-0.5B-Instruct 后,聊天页的 Pick a model 下拉立刻出现了它。
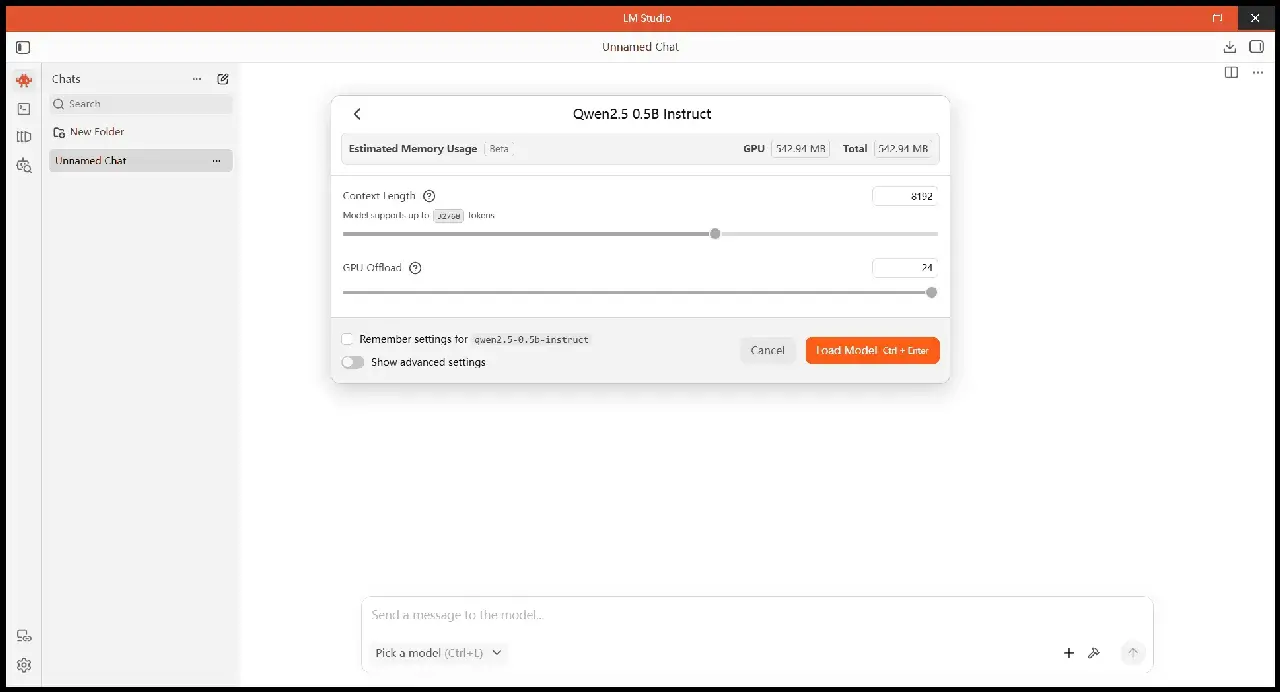
加载前先看资源预估。点模型会弹出加载配置:预估内存占用(实测 Qwen2.5-0.5B 为 542.94 MB)、上下文长度(默认 8192,模型支持到 32768)、GPU Offload 层数(默认拉满)。心里有数再点 Load Model。
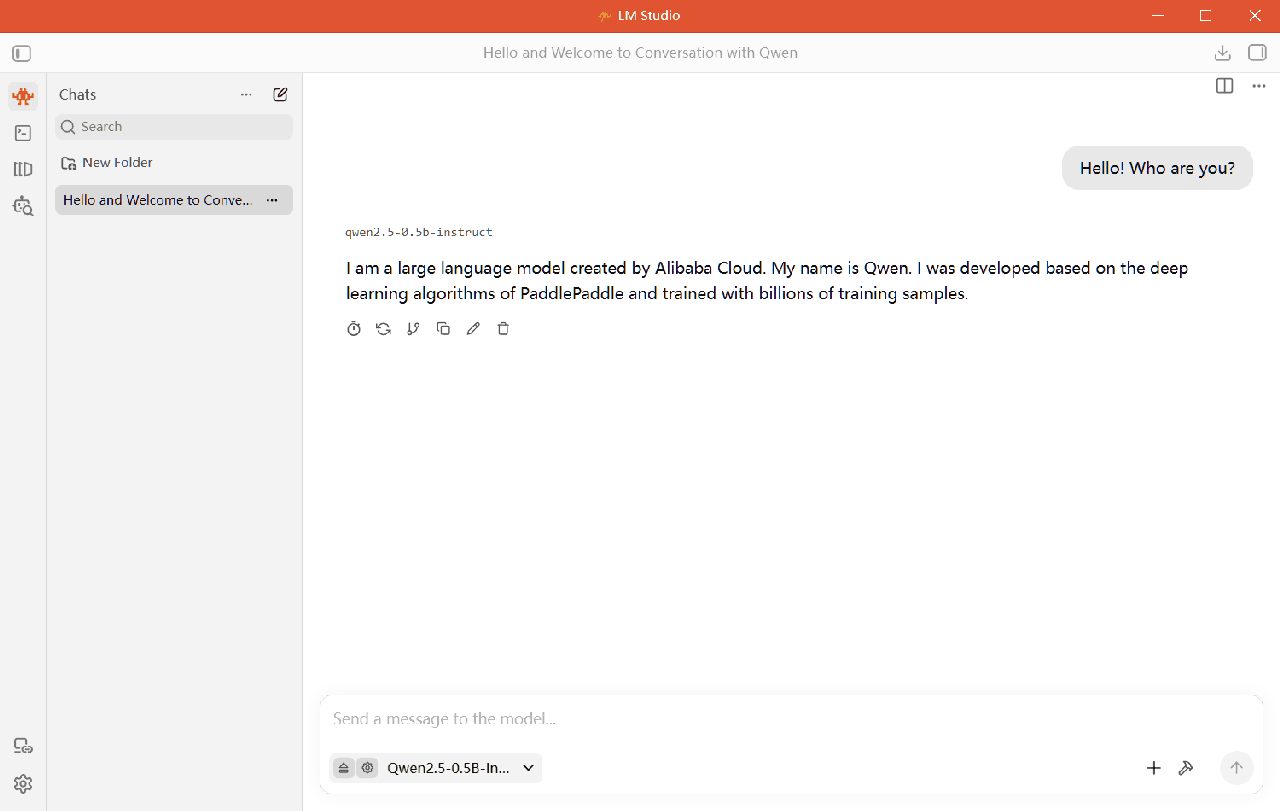
真实离线对话。加载完成后直接在输入框说话,模型本地生成、不联网。实测问「Hello! Who are you?」,Qwen2.5-0.5B 稳定输出自我介绍;每条回复带时间、重新生成、分支、复制、编辑、删除六个操作按钮。
内置本地 API 服务:OpenAI 兼容接口
Developer 页里藏着一个本地服务器:开关一开就是 OpenAI 兼容 + Anthropic 兼容两套 API(外加 LM Studio 自有 REST API v1),模型已经加载好的话立刻可用。实测用 curl 调 /v1/chat/completions,返回标准的 JSON 补全和 token 用量统计(prompt 37 + completion 47 = 84 tokens),和调用 ChatGPT 接口的代码完全同构——把 base_url 换成本地服务地址(本机回环 IP 加端口再加 /v1,下图示例为 8899 端口),就能把本地模型接进沉浸式翻译、代码助手等一切支持自定义 OpenAI 接口的工具。
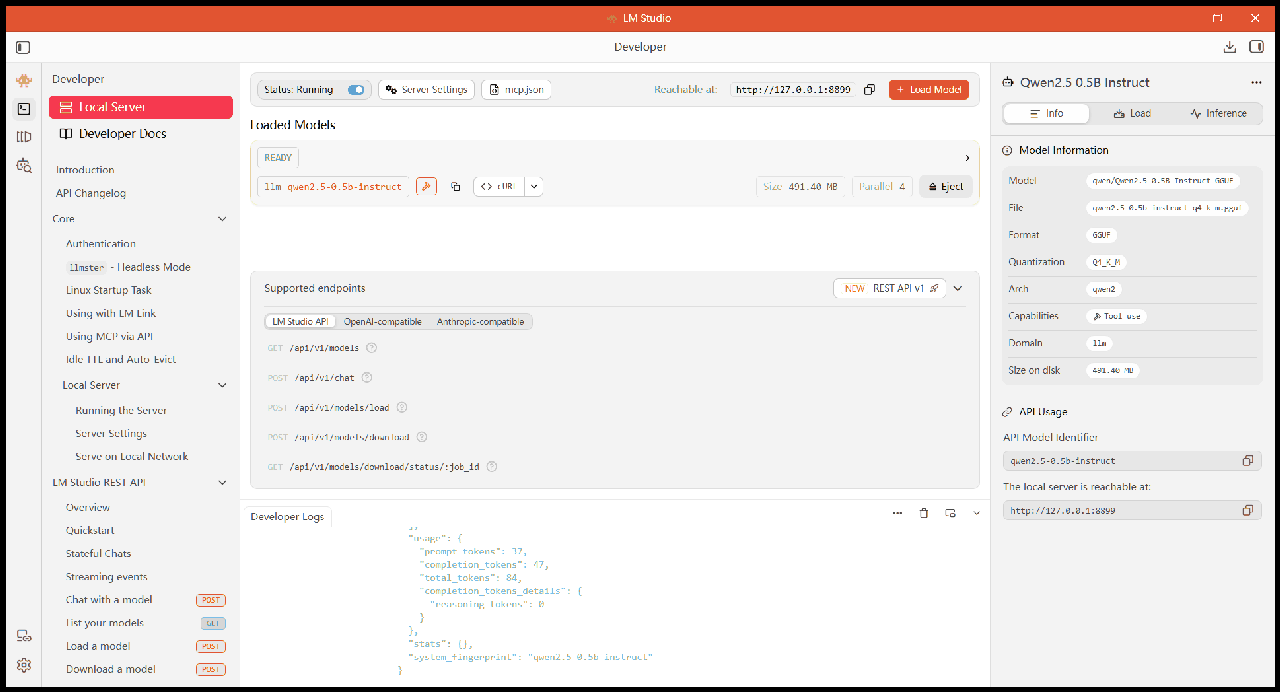
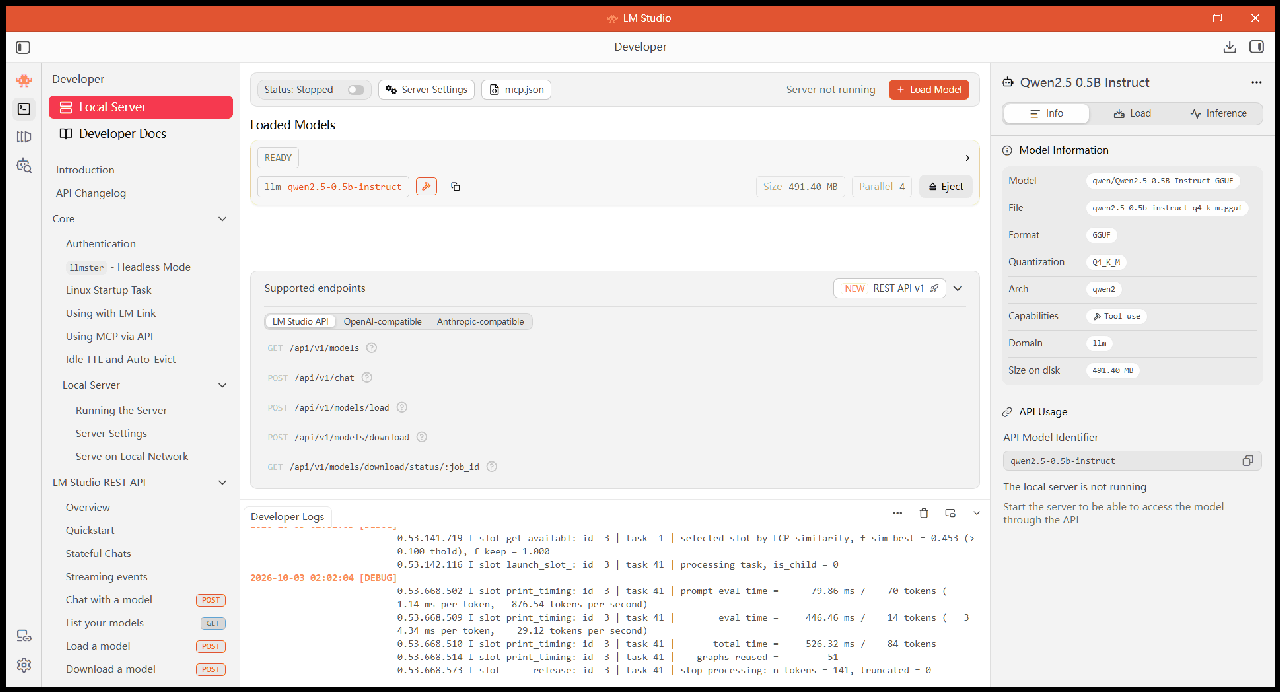
Developer Logs 还能直接看到推理性能:实测 Qwen2.5-0.5B 的 prompt 处理速度约 876.54 tokens/秒,生成速度约 29.12 tokens/秒(日志原文 876.54 tokens per second / 29.12 tokens per second)。想给本地模型做性能摸底,看这个日志页就行。
国内网络怎么下模型(实测可行的 ModelScope 方案)
LM Studio 内置的模型市场走 Hugging Face,国内直连经常超时(实测 huggingface.co 直连打不开)。可行的替代路径:
- 打开魔搭 ModelScope(modelscope.cn,国内直连秒开),搜模型名 + GGUF,例如「Qwen2.5-0.5B-Instruct-GGUF」;
- 下载其中一个
.gguf文件(文件越大精度越高,0.5B 模型的 Q4_K_M 约 491MB); - 放进模型目录
C:\你的用户名\.lmstudio\models\发布方\模型名\(具体路径在 Settings → Models Directory 里能看到); - 回到聊天页点 Pick a model,模型已经出现在列表里。
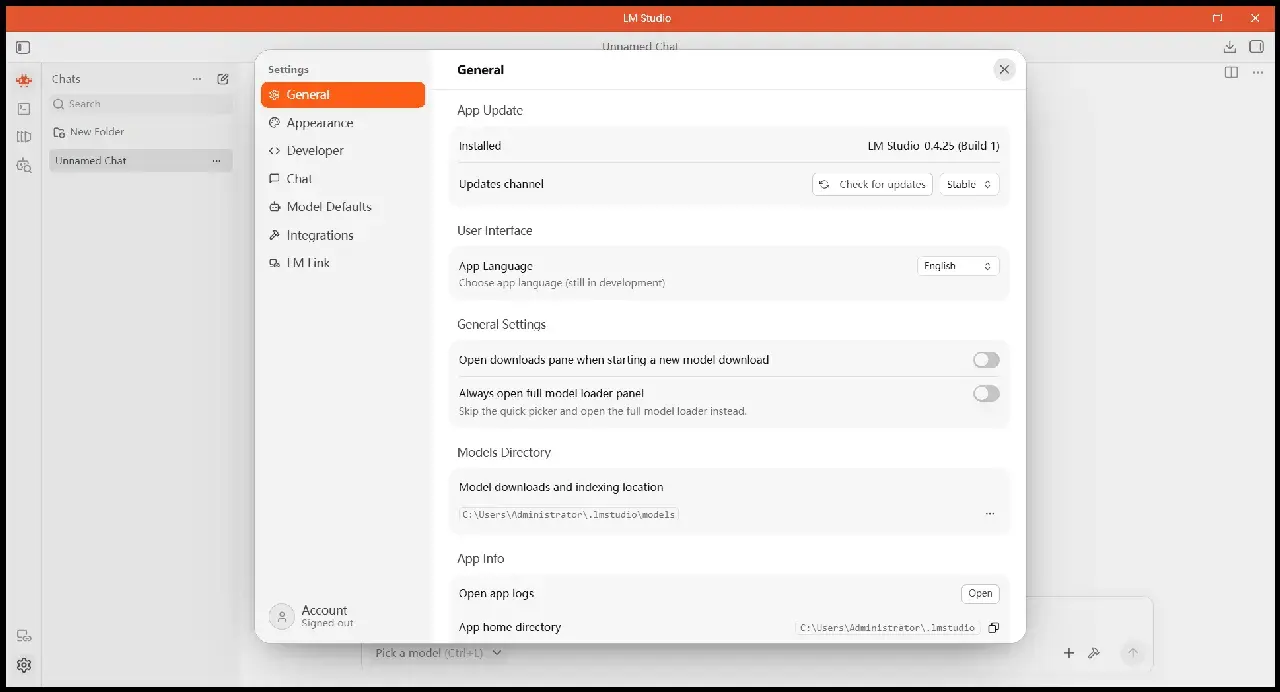
Settings → App Language 里有多语言选项(Beta 标注、开发中),目前默认 English;对界面有中文刚需的话,建议等后续版本把翻译做完。
实测重点
- 安装零捆绑:官方 NSIS 安装器静默装完即用,没遇到推广勾选和全家桶;唯一要留意的是引导页里「Start local LLM service on login」(开机自启本地服务)默认是开的,不需要就顺手关掉
- 安装体积:装完 294.7 MB(含 210MB 的主程序),比安装包小,因为运行时按需加载
- 默认端口 1234 可能起不来:实测本机报
EACCES: permission denied 127.0.0.1:1234(端口被系统保留段占用),用lms server start --port 8899或界面 Server Settings 换个端口即可,服务本身没有问题 - 命令行工具齐全:安装后自带
lmsCLI(在C:\用户名\.lmstudio\bin\),lms ls列模型、lms server start起服务,写脚本很方便;实测lms ls正确报出 2 个模型共 575.51 MB - 模型识别范围:支持标准 GGUF(llama 系架构),实测 Qwen2 架构识别无误,模型信息页能读出参数量、量化格式、能力标签(本次模型带 Tool use 标记)
软件信息
| 项目 | 内容 |
|---|---|
| 软件名称 | LM Studio(Element Labs Inc. 出品) |
| 当前版本 | 0.4.25 (Build 1) |
| 软件大小 | 安装包 588.2 MB / 装完 294.7 MB |
| 系统要求 | Windows 64 位(另有 macOS / Linux 版) |
| 语言界面 | 英文默认,多语言 Beta 跟进中 |
| 模型格式 | GGUF(llama.cpp 系),支持工具调用模型 |
| 是否收费 | 个人和公司使用均免费,闭源 |
| 是否需要登录 | 不需要,离线可用 |
关于病毒扫描与包安全
- 本包从 lmstudio.ai 官方 CDN 直链下载,未经任何第三方修改,官方数字签名验证 Valid
- SHA-256:
76C025EF4ABF38EDAC36DA09CE1A54D2803B3871A074B95BD9DFFDB231458F0C,可用命令certutil -hashfile 文件名 SHA256自行比对 - 多引擎病毒扫描结果待补扫,扫完回填本节