WhisperBar · 浮声
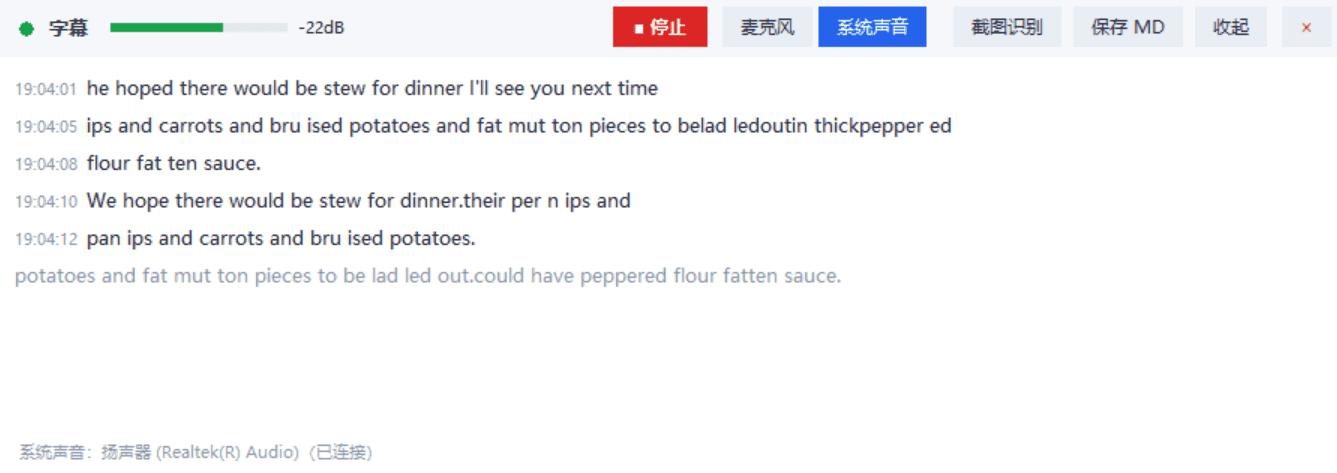
Windows 上的实时悬浮字幕条 —— 说话或放视频,屏幕底部浮出一条半透明字幕,一键存成 Markdown。
Real-time floating subtitles for Windows. Captures your microphone or whatever your PC is playing, shows a single translucent line at the bottom of the screen, and exports everything (text + screenshots) to Markdown.
自带 Python、CUDA 运行库、ffmpeg 和模型,不需要你装任何东西。装完约 5.5 GB,全程离线可用。
开源地址:JHSwordsman/WhisperBa: **Windows 上的实时悬浮字幕条** —— 说话或放视频,屏幕底部浮出一条半透明字幕,一键存成 Markdown。
下载地址
123网盘:https://1626683.share.123pan.cn/123pan/ekeA-JIYw
它解决什么问题
看网课、听会议、刷英文视频时,想有字幕但不想切窗口;想记笔记但打字跟不上。
现有方案要么只能录麦克风(浏览器里的网页版),要么得自己装 Python、配 CUDA、下模型。这个项目把整条链路打成一个双击就能用的 Windows 包:
| 你想要的 | 这里的做法 |
|---|---|
| 不挡视线 | 默认折叠成一条 52px 半透明字幕浮在屏幕底部,鼠标不碰它就是纯文字 |
| 录电脑里的声音 | Windows WASAPI 环回,不用装 VB-Cable 虚拟声卡,也不占麦克风 |
| 顺便截图做笔记 | 框选画面 → 图片存档 → 和当前这段字幕绑在一起 |
| 整理成笔记 | 一键导出 Markdown,图片自动进 attachments/,整个文件夹丢进 Obsidian 就能用 |
| 不想看碎片字幕 | 流式结果自动聚合成整句(遇标点 / 满 5 秒 / 停顿 1.2 秒才断行) |
特性
- 三种音源:麦克风 / 系统播放声音 / 截图存档,一条字幕条全包
- GPU 加速:CTranslate2 + CUDA,RTX 5070 上 3 秒音频推理 0.36 秒;没 N 卡自动降级 CPU
- 完全离线:模型内置在本地,断网也能用
- 零污染:Python 和依赖全在
runtime/里,不碰你系统装的东西 - 网页版也在:
start.bat提供官方 Web UI + REST API + Deepgram 兼容端点 - 可换模型:
large-v3-turbo(默认)/large-v3/medium/small,改一行配置
快速开始
要求:Windows 10/11 x64,8 GB 内存,约 6 GB 磁盘。NVIDIA 显卡可选(有就快很多)。
方式一:下载 ZIP(推荐,约 11 MB)
- 右上角 Code → Download ZIP,解压到任意目录
- 双击
WhisperBar.exe - 首次会弹出安装向导,点「开始安装」—— 它自己下载 Python、依赖和模型(约 5 GB,10~30 分钟)
- 装完自动启动,以后每次双击就直接用
仓库里只有源码和启动器(11 MB),运行时和模型由安装向导现场拉取。
国内源已配好:Python 走华为云、PyPI 走华为云、模型走 hf-mirror,不用梯子。
方式二:完整离线包(约 5.5 GB)
到 Releases 下载完整包(分卷压缩),解压后双击 WhisperBar.exe 即可,不需要联网装任何东西。
适合:网络不好、要拷到内网机器、或者给不折腾的人用。
方式三:从源码安装
git clone https://github.com/<your-name>/whisperbar.git
cd whisperbar
install.bat
install.bat 会依次完成:
- 下载 Python 3.12.10 embeddable(11 MB,华为云镜像)
- 解压到
runtime/python,修好._pth - 装 pip,按
requirements.txt装依赖(约 3.5 GB,华为云 PyPI 镜像) - 把 ffmpeg 复制到
bin/ - 下载
faster-whisper-large-v3-turbo(1.6 GB)+small(0.5 GB),走 hf-mirror - 生成启动预热音频
全程 10~30 分钟,视网速。中断了可以重跑,已完成的步骤会跳过。
装完双击 WhisperBar.exe(或 float.bat)即可。
使用
悬浮条
启动后屏幕底部出现一条深色半透明字幕:
● 正在说的这句话……
- 鼠标移上去 → 冒出一排按钮:
▶开始系统声音/麦克风截图保存展开× - 点一下字幕条 → 展开成完整面板,能看全部历史 + 截图缩略图
- 按住拖动 → 挪到任意位置
- 双击标题栏 → 收起 / 展开
启动时按钮会先亮 4 秒,告诉你这里有东西。
三个能力
| 能力 | 操作 |
|---|---|
| 麦克风 | 点「系统声音」切成「麦克风」,点 ▶开始 |
| 电脑播放的声音 | 默认就是这个,点 ▶开始 即可 |
| 截图存档 | 点「截图」,屏幕变暗后拖拽框选,松手即存 |
分句规则
流式转写本来是一小段一小段吐的,直接显示就是碎片。这里的聚合策略:
- 遇到
。!?!?→ 立刻成一行 - 一句话攒满 5 秒 → 强制断行
- 停顿超过 1.2 秒 → 认为这句说完了
折叠条上显示的是正在说的这句(超长只留尾巴),展开面板里是「一句一行」。
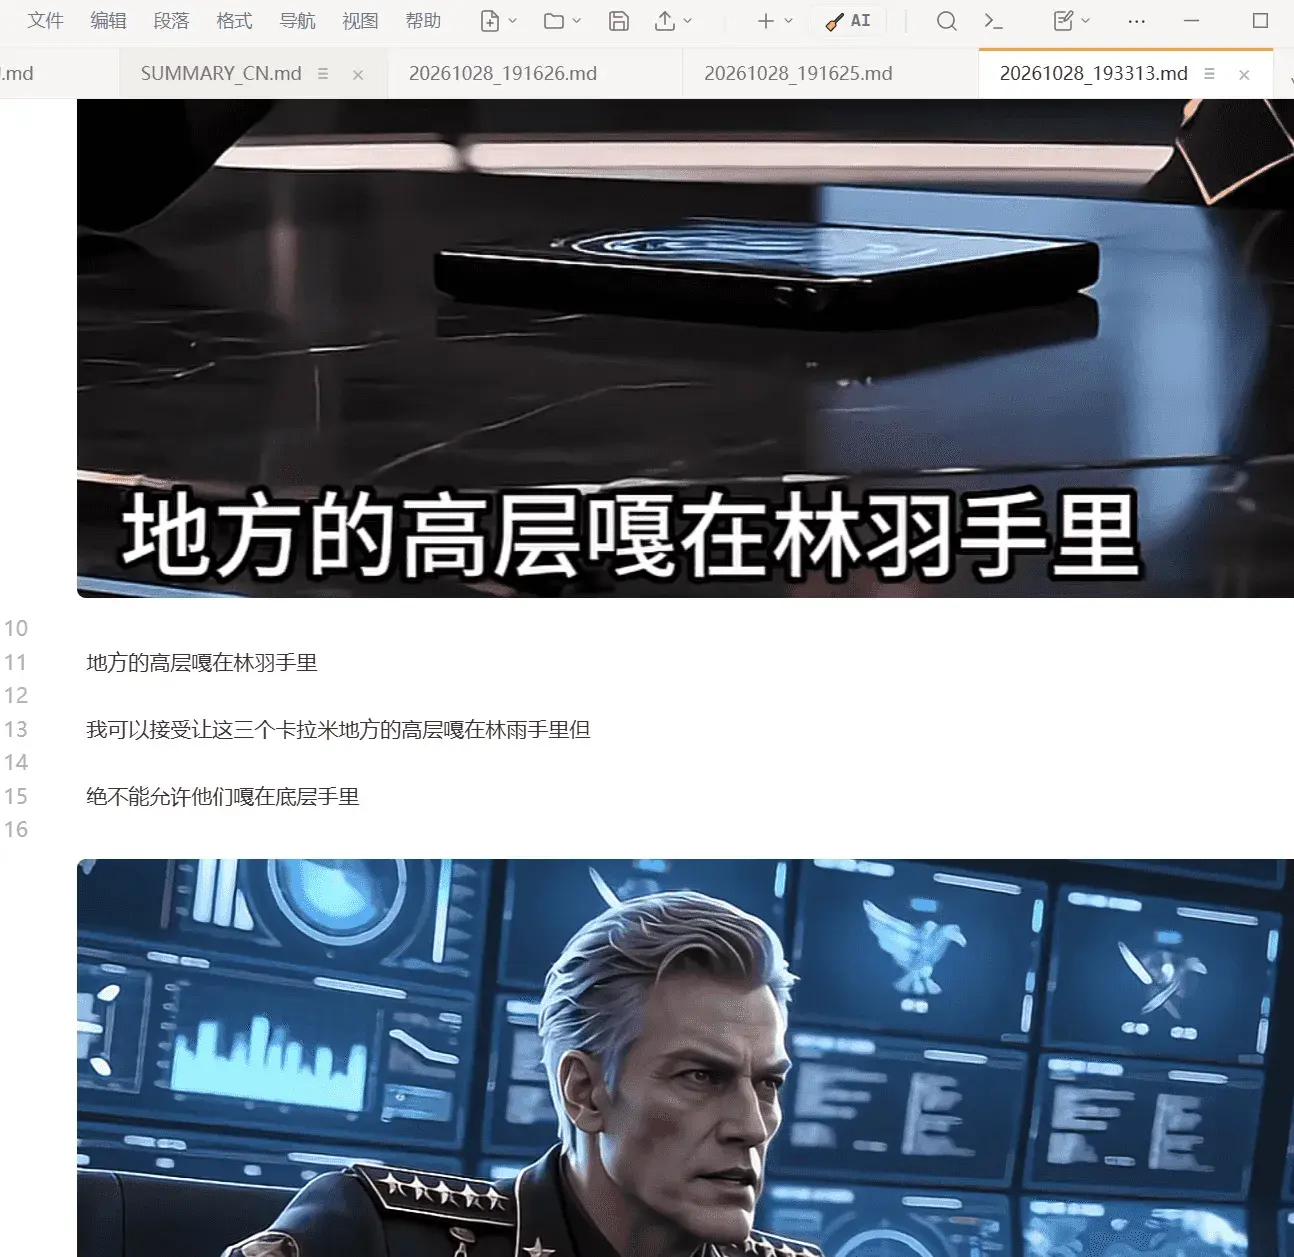
导出 Markdown
点「保存」生成:
output/
├─ 20261028_190436.md
└─ attachments/
   └─ 20261028_190427.png
## 19:04:27

这一段正在讲的内容……
同一时间段(10 秒内)的字幕和截图合并成一个 ## 时间 小节,图文放一起。用标准 Markdown 语法,整个 output/ 文件夹拖进 Obsidian vault 就能直接用。
其他入口
| 文件 | 用途 |
|---|---|
float.bat |
悬浮字幕条(推荐) |
start.bat |
命令行 + 网页 UI(http://127.0.0.1:8000) |
capture.bat |
命令行版系统声音内录,带电平条 |
check.bat |
环境自检(CUDA / 模型 / 实机推理计时) |
命令行内录也支持参数:
runtime\python\python.exe tools\capture_system_audio.py --language zh --duration 60
runtime\python\python.exe tools\capture_system_audio.py --list
它是怎么工作的
┌─────────────┐   WASAPI 环回 / 麦克风
│ soundcard   │──────────────────────┐
└─────────────┘                      │  16 kHz 单声道 PCM
                                     ▼
                          ┌────────────────────┐
                          │ WebSocket 推流      │  /v1/listen?encoding=linear16
                          └─────────┬──────────┘
                                    ▼
                     ┌──────────────────────────────┐
                     │ WhisperLiveKit (uvicorn)     │
                     │ faster-whisper + CTranslate2 │
                     │ CUDA float16 / CPU int8      │
                     └──────────────┬───────────────┘
                                    ▼  增量字幕 JSON
                     ┌──────────────────────────────┐
                     │ tkinter 悬浮窗                │
                     │ 去重 → 句子聚合 → 渲染        │
                     │ 截图存档 → 导出 Markdown      │
                     └──────────────────────────────┘
几个关键决策:
- 走 Deepgram 兼容端点而不是
/asr:/v1/listen?encoding=linear16是会话级开启 PCM 模式,不用给服务端加--pcm-input,网页那条麦克风链路完全不受影响。 - 截图不是 OCR:截图是存档,OCR 只是顺带(Windows 自带 OCR 引擎,有字就贴在图片下面)。
- torch 是 CPU 版:PyPI 的 Windows wheel 只有 CPU 版,但语音识别走 CTranslate2,不经过 torch,不影响速度。
性能实测
RTX 5070 Laptop 8G / 驱动 610.47 / large-v3-turbo:
| 项目 | 结果 |
|---|---|
| CTranslate2 识别到 CUDA 设备 | 1 个,支持 float16 |
| 模型加载(GPU) | 0.8 s |
| 3 秒音频推理(GPU float16) | 0.36 s |
| 3 秒音频推理(CPU int8) | 1.13 s |
| 10 秒音频 REST 转写(含 ffmpeg 解码) | 1.7 s |
| 冷启动到可录音 | 20~40 s(模型加载) |
常见问题
Q:双击 float.bat 没反应 / 一闪而过
先跑 install.bat。已经装过的话双击 check.bat 看自检输出,日志在 logs/。
Q:字幕条一直显示「正在启动转写服务…」
模型加载要 20~40 秒。超过 2 分钟还没好,看 logs/server.log。
Q:没有字幕 / 电平条不动
说明没抓到声音。runtime\python\python.exe tools\capture_system_audio.py --list 看设备,
确认声音是从哪个设备出来的。蓝牙耳机切过去后要重开一次。
Q:GPU 没吃上check.bat 里找 [OK] cuda/float16。如果是 [x],多半是驱动太旧或不是 N 卡。
AMD / Intel 显卡在 Windows 上 CTranslate2 没有对应后端,只能走 CPU。
Q:想换小一点的模型
改 float_app.py 里 _launch_server() 的 model_dir,或 start.bat 里的 MODEL。
可选:faster-whisper-small(0.5G,已内置)/ medium(1.5G)/ large-v3(3.1G)。
runtime\python\python.exe tools\download_model.py Systran/faster-whisper-large-v3 faster-whisper-large-v3
Q:端口 8000 被占用
改 start.bat / float_app.py 里的端口。悬浮窗默认连 8000。
Q:为什么仓库里没有 runtime 和 models?
加起来 5.5 GB,超出 GitHub 限制。用 install.bat 拉,或者下 Release 里的打包版。
目录结构
whisperbar/
├─ WhisperBar.exe         ★ 双击这个(启动器,10 MB)
├─ install.bat            一键安装(下载 Python + 依赖 + 模型)
├─ float.bat              悬浮字幕条(命令行启动,exe 的等价物)
├─ start.bat              命令行 + 网页 UI
├─ capture.bat            命令行内录
├─ check.bat              环境自检
├─ requirements.txt
├─ assets/warmup.wav      启动预热音频
├─ tools/
│  ├─ launcher.py         启动器源码(打包成 WhisperBar.exe)
│  ├─ bootstrap.py        安装脚本
│  ├─ float_app.py        悬浮窗(tkinter)
│  ├─ asr_engine.py       音频采集 + 推流 + 去重
│  ├─ ocr_tool.py         Windows OCR 封装
│  ├─ run_server.py       服务启动器(设备检测、自动开浏览器)
│  ├─ capture_system_audio.py  命令行内录
│  ├─ selftest.py         自检
│  └─ download_model.py   模型下载
└─ (安装后生成)runtime/ models/ bin/ shots/ output/ logs/
已知限制
- 只支持 Windows(WASAPI 环回、Windows OCR、tkinter 无边框窗口都是平台相关的)
- 不支持说话人分离(需要 NeMo,约 3 GB,没打包)
- 只做了 NVIDIA CUDA 加速,AMD / Intel 走 CPU
- 默认模型是
large-v3-turbo,中文效果不错,但强口音和远场录音仍会出错
致谢
- WhisperLiveKit —— 流式转写服务端
- faster-whisper / CTranslate2 —— 推理引擎
- SoundCard —— WASAPI 环回采集
- winocr —— Windows 自带 OCR
- OpenAI Whisper —— 模型
License
MIT。第三方组件许可见 LICENSE 末尾。