SenseVoice 的作用是把中、英、日、韩、粤五种语言的语音直接转成文字,同时识别说话人的情绪(喜怒哀乐)和背景的掌声、笑声、哭声等声音事件。它是阿里通义实验室开源的语音识别模型,一句话音频一次就出「文字 + 情绪 + 环境事件」。
开源模型免费,走本地 / 自托管路径,数据不出本机,CPU 就能跑。阿里云百炼的 SenseVoice 录音识别云端 API 已公告即将下线,本文只讲本地开源这条线。
下载地址
| 资源 | 说明 |
|---|---|
| 官方仓库 (GitHub) | QwenAudio/SenseVoice,模型 SenseVoiceSmall |
官网:https://github.com/QwenAudio/SenseVoice 版本:模型 SenseVoiceSmall(最新 release runtime-llamacpp-v0.2.1,2026-08-27) 体积:模型约 200MB 量级,ONNX / GGUF 量化版约 242MB 部署前提:无 GUI 安装包,走命令行 / FunASR / llama.cpp / Sherpa-onnx 部署
功能介绍
五语转写加情绪识别
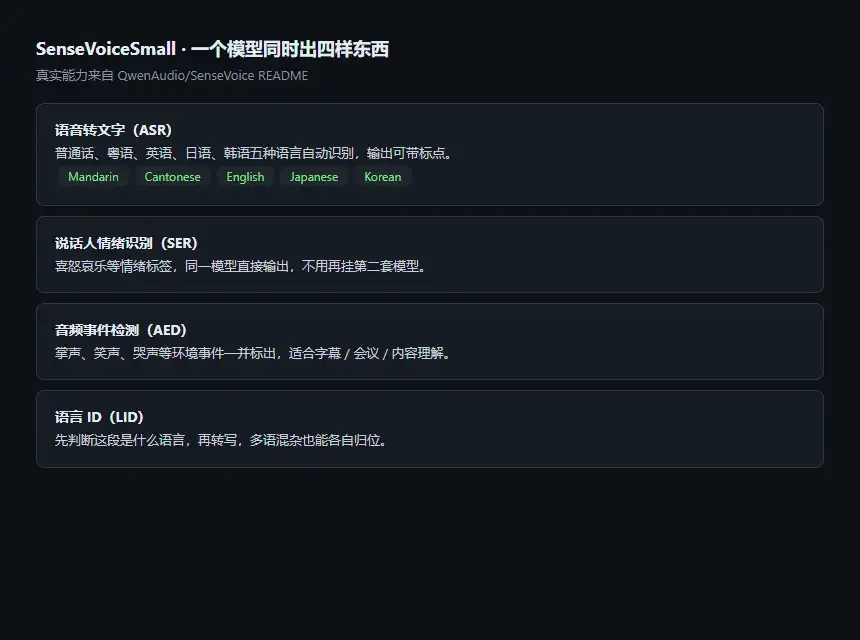
一个模型同时输出中英日韩粤五语文字、说话人情绪和掌声 / 笑声等声音事件,输出可带标点。适合字幕生成、会议记录、粤语等方言转写。
CPU 本地就能跑
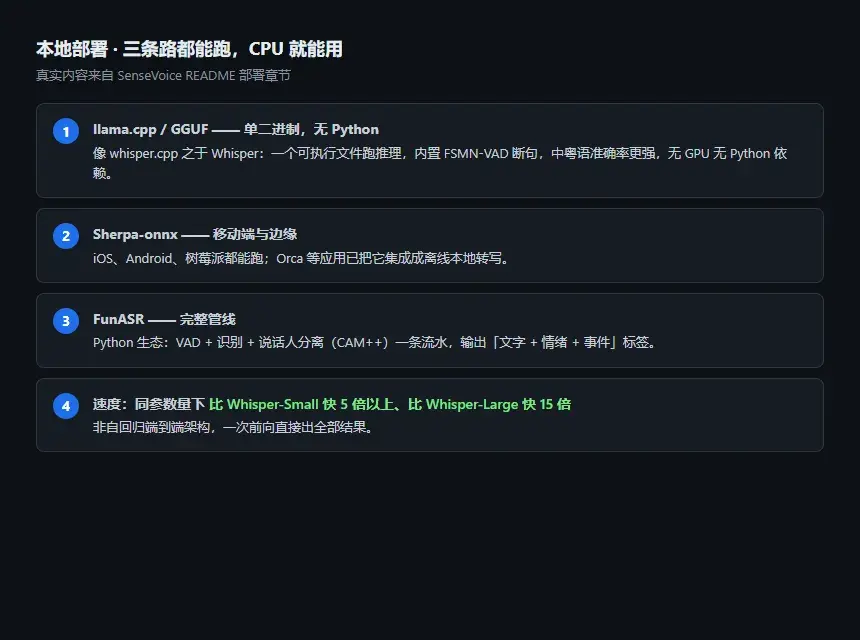
非自回归端到端架构,同参数量下比 Whisper-Small 快 5 倍以上、比 Whisper-Large 快 15 倍;纯 C/C++ 推理,支持树莓派、iOS、Android。
软件信息
- 软件名:SenseVoice(SenseVoiceSmall)
- 版本:模型 SenseVoiceSmall(runtime-llamacpp-v0.2.1,2026-08-27)
- 大小:模型约 200MB 量级(量化版约 242MB)
- 许可证:MIT
- 平台:开源模型,跨平台(llama.cpp / Sherpa-onnx / FunASR,支持树莓派、iOS、Android)
- 官方地址:https://github.com/QwenAudio/SenseVoice