一台 Windows 就能跑的本地判断模型:Laya
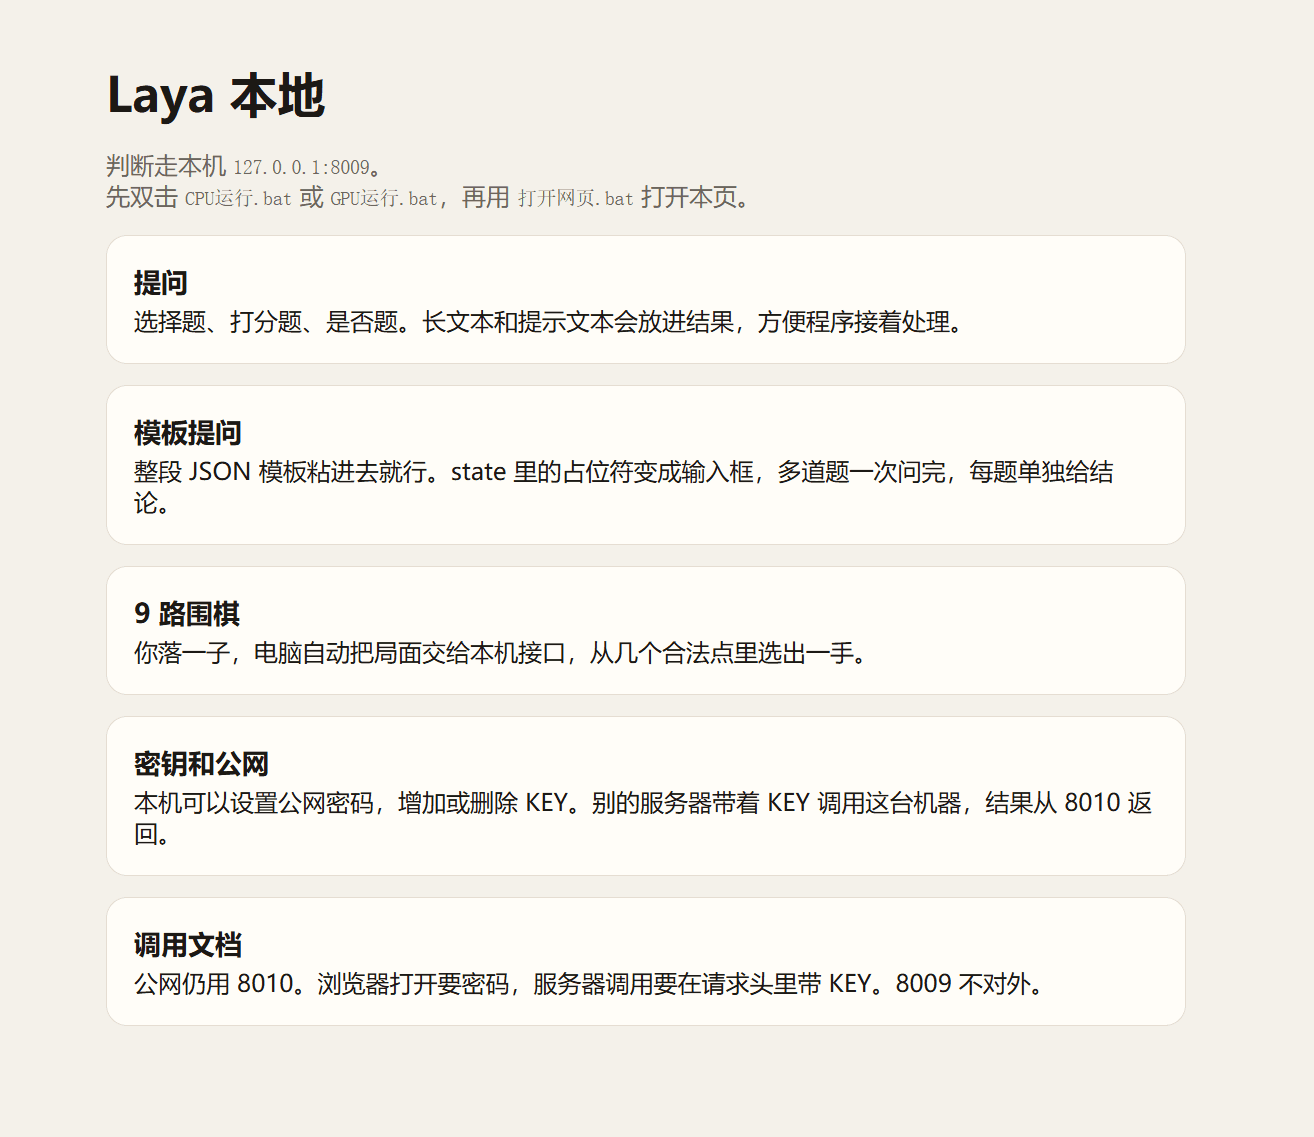
把整个 laya 文件夹拷到另一台 64 位 Windows 上就能用。里面已经带好运行环境、模型和网页,不用再装 Python。双击 CPU运行.bat 或 GPU运行.bat,再双击 打开网页.bat,浏览器打开本机页面就能提问。
它做的是类型化判断。你给一段文本,再出几道题,它返回带概率和置信度的 JSON,程序可以直接接着处理。题有三种,一次请求里可以混着问:
- 选择题(choice):从你写好的选项里选一个,并给出每个选项的概率
- 打分题(score):按你定的档位打一个分
- 是否题(noul):判断成立还是不成立
下载地址:
123网盘:https://1626683.share.123pan.cn/123pan/ekeA-q2aw
举个客服里的例子。用户说:「我的信用卡被扣了两次款,麻烦退一笔。」可以同时问三件事:该转给账单、技术还是销售;这句话有没有时间压力;客户不满到哪一档。账单组会吃到绝大部分概率,后面两题也各自给出结论。换一句「设置页白屏,控制台报 TypeError」,同一套题会转到技术组。文本可以是一整段话,也可以是带用户、套餐、附件的结构化对象。
骨干是 mmBERT-base,大约 3.2 亿参数,走的是 Jev / System One 那套 POST /v1/systemone 协议。推理在本机完成,文本不出机器,不需要 API key,运行时也不需要 PyTorch。
速度和体积:
- CPU 用 INT8 模型,大约 324 MB。4 核 CPU 上单题大约 15 毫秒,三题大约 45 毫秒。
- GPU 用另一份 FP32 模型,大约 1.3 GB。RTX 5070 上单题中位大约 5 毫秒。
- 同样的请求打到官方托管接口,中位大约 314 毫秒,里面包含一次网络往返。
新闻四分类上,INT8 大约 91%,FP32 大约 93%。显卡覆盖 RTX 20 系到 50 系,CUDA 运行库已经打进包里,不用单独装 CUDA Toolkit。没有显卡的机器删掉 GPU 模型和运行库,只留 CPU 即可。INT8 留给 CPU,FP32 留给显卡,两套不要混着跑。
别的服务器要调用这台机器时,入口是 8010。本机页面上设一个公网密码、发一把 KEY,点开放公网后再重启一次网页服务。浏览器进来要密码,程序进来在请求头里带 Authorization: Bearer laya_...。真正的推理留在本机 8009,不映射到公网。
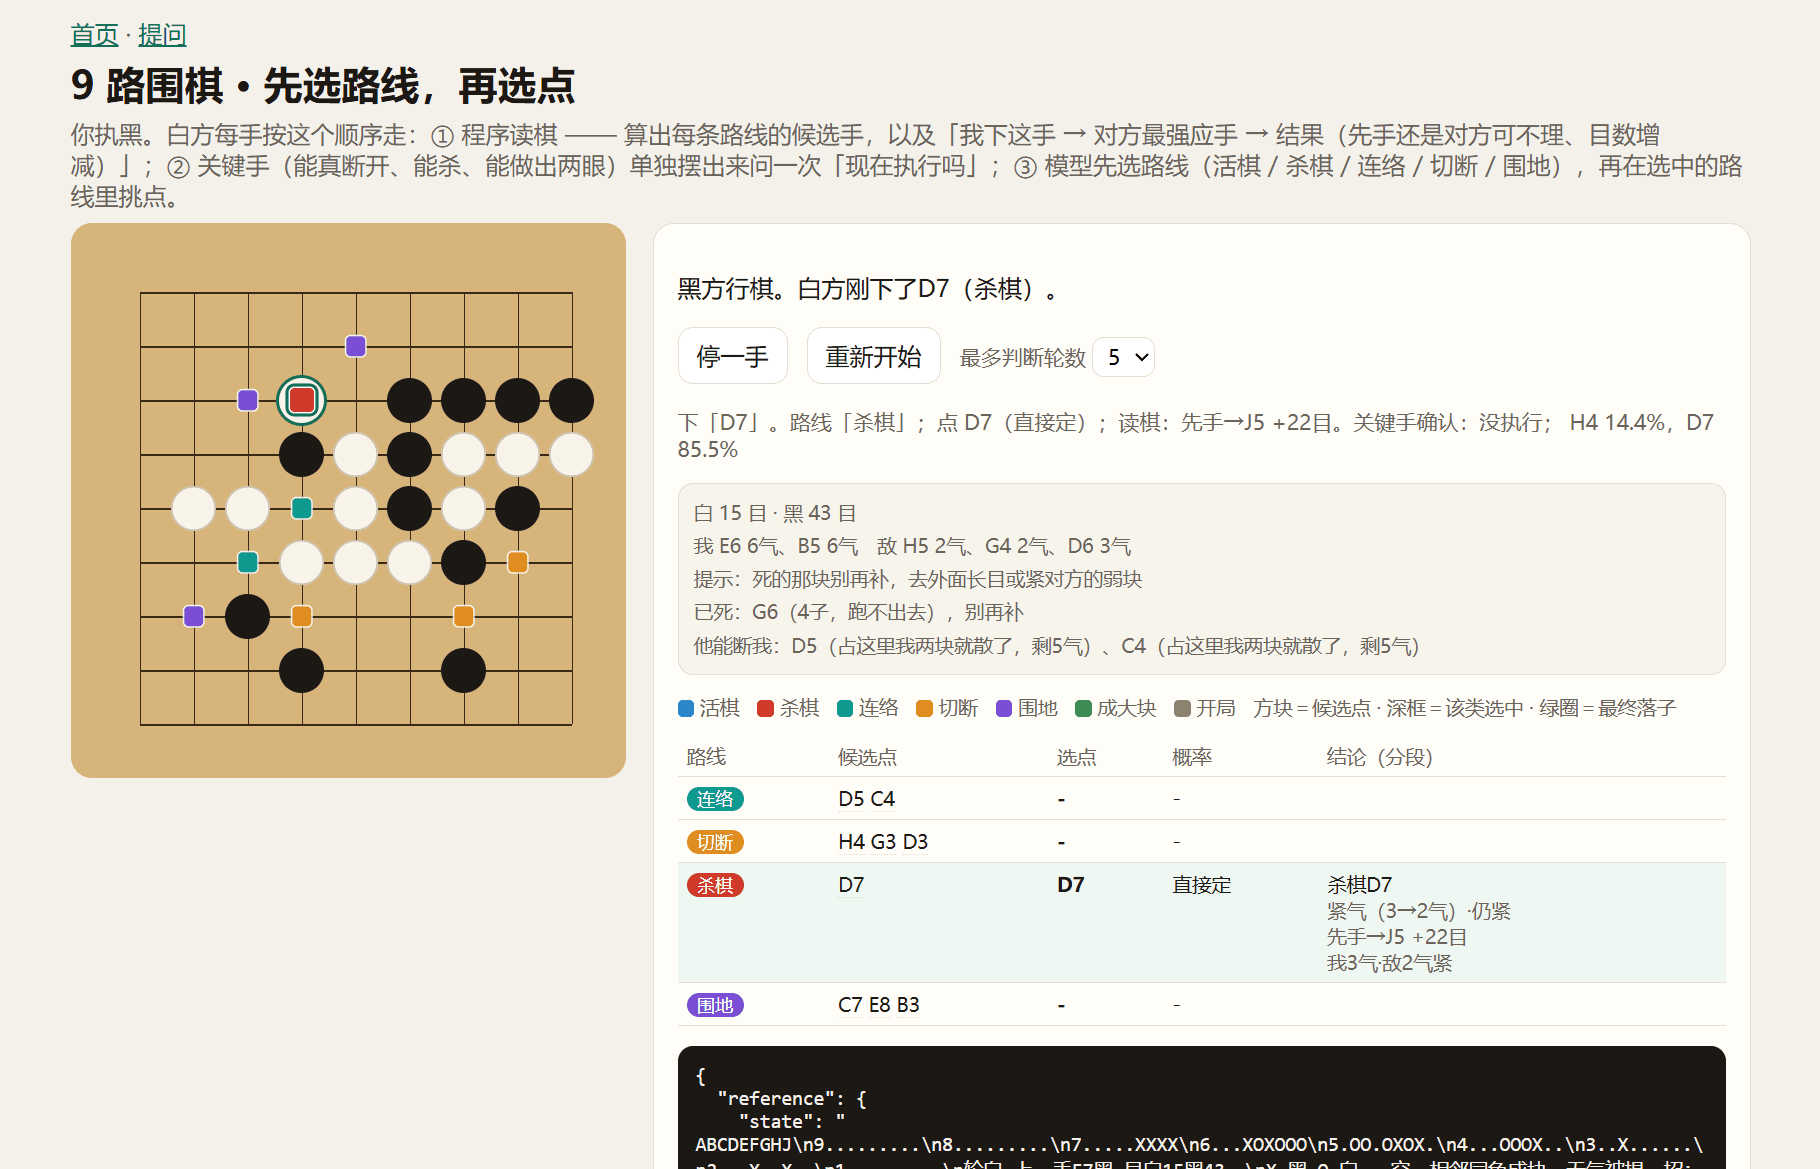
网页上可以直接试四件事:普通提问、把一整段 JSON 模板贴进去一次问完、密钥和公网开关,以及一盘 9 路或 19 路围棋。围棋那边是你落一子,局面交给同一套接口,从合法点里选出一手。
适合嵌进客服分流、工单优先级、情绪或意图打标,以及原文不能离开内网的判断环节。文件夹就是一份便携包,拷走即用。