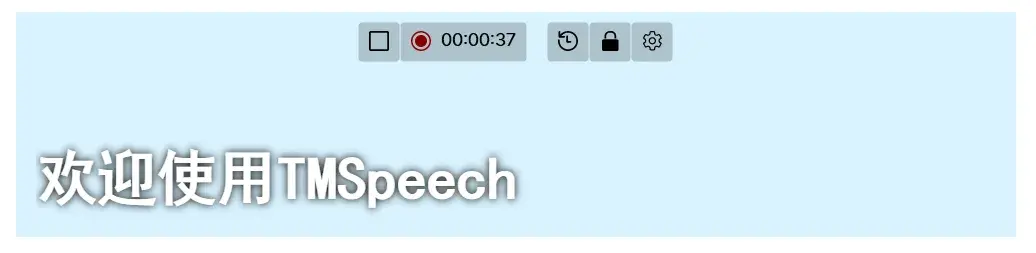
TMSpeech 的作用是把电脑正在播放的声音(会议、网课、视频里的语音)实时识别成字幕,悬浮窗像歌词一样显示在屏幕上。识别全程在本地离线完成,音频数据不出本机,不依赖网络。
免费开源(MIT 许可证),仅 Windows,绿色解压不写注册表。想上手的话,先把包选对:主程序 zip 约 156 MiB,里面不含识别模型;FunASRNano 整合包约 909 MiB,自带模型和 Python 运行环境,解压即有完整识别链路。
下载地址
| 资源 | 说明 |
|---|---|
| 官方 | GitHub Releases v0.4.3-funasr(2026-07-15):主程序 TMSpeech.win-x64.zip(156 MiB,不含模型)|TMSpeech.win-x64-FunASRNano.7z(909 MiB,自带 Fun-ASR-Nano 模型);v0.4.3 tag 下另有 ncnn / onnx / sensevoice 三种模型包可与主程序配套 |
| 123云盘 | 主程序 zip:https://1626683.share.123pan.cn/123pan/ekeA-hu5I?pwd=8888# |
官网地址:https://github.com/jxlpzqc/TMSpeech ;体积:win-x64.zip 163,440,480 字节(约 156 MiB),FunASRNano 包 953,307,071 字节(约 909 MiB)。123 链接提取码 8888。
功能介绍
三种捕获方式,系统静音也能识别
可抓系统声音、麦克风或指定进程的音频,设置里三选一;系统声音走 WASAPI 回环捕获,官方明确「即使完全关闭电脑声音也能使用」。指定进程捕获是 v0.4.3-funasr 这一版新增的能力(官方更新说明),可以只抓某一个程序的音频。
识别引擎三选一,结果可回看
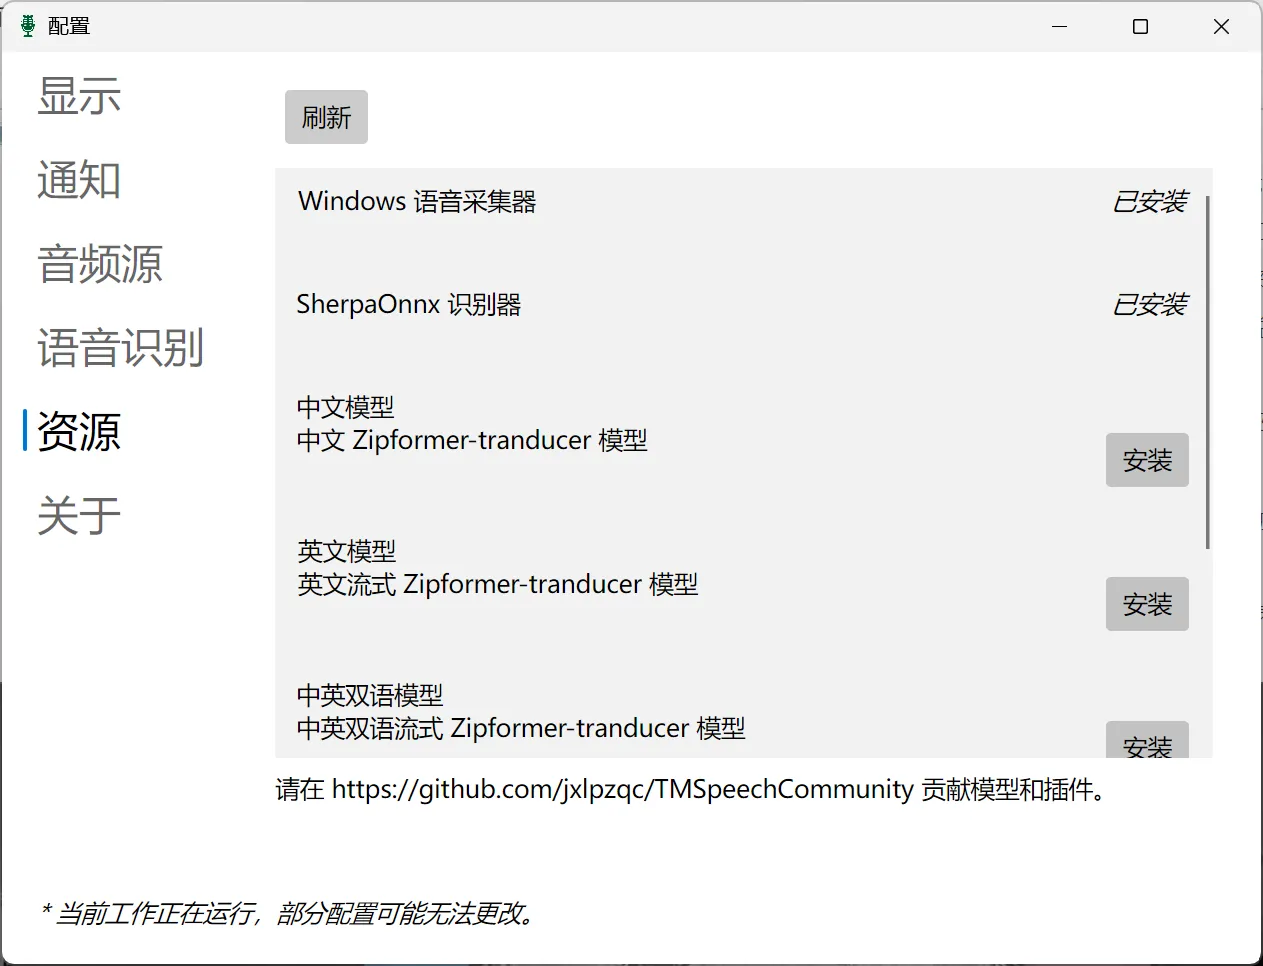
识别器有 SherpaOnnx、SherpaNcnn、命令行外挂三种,模型目录在设置里自选,也可以换其他开源模型。识别结果记入历史记录页面,可右键或 Ctrl-C 复制,并按日期存到「我的文档」的 TMSpeechLogs 文件夹——本机启动后这个目录确实自动创建了。CPU 占用方面,作者在 README 里给出的是 AMD 5800u 笔记本上不到 5% 的数据。
本机实测:主程序解压后直接打开主界面和悬浮字幕窗,无崩溃;FunASRNano 整合包的识别脚本能正常启动并枚举音频设备,但喂官方测试语音时输出为空——这是 sherpa-onnx 的已知 bug(issue #3993:Fun-ASR-Nano int8 模型在 Windows x86_64 CPU 上 int8 溢出,生成 0 token),截至发稿仍 open。想避开这个坑,用主程序配 v0.4.3 tag 的 ncnn/onnx 模型包更稳;整合包等上游修复后再用。
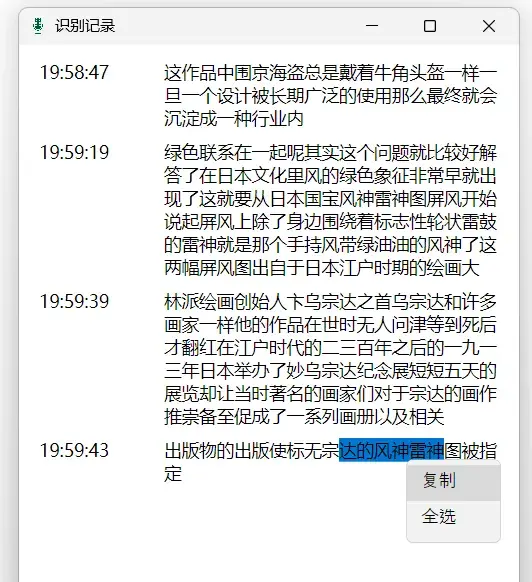
界面图取自项目主页的官方展示截图。
软件信息
| 项目 | 内容 |
|---|---|
| 软件名 | TMSpeech |
| 版本 | v0.4.3-funasr(2026-07-15 发布,Releases 最新) |
| 大小 | win-x64.zip 约 156 MiB;FunASRNano 包约 909 MiB |
| 许可证 | MIT |
| 平台 | Windows(x64) |
| 官方地址 | https://github.com/jxlpzqc/TMSpeech |
标签:TMSpeech、实时字幕、本地离线转写