colibri(也写作 Colibrì)是一款由 JustVugg 开发的本地大模型推理引擎,引擎本体用纯 C 写成,每个模型族一个 C 文件(GLM-5.2 是 c/colibri.c,约 1.4 万行),共用同一套头文件,运行时不依赖 Python——Python 只负责安装向导、启动器和 API 网关。它要解决的事很直接:让一台只有约 25GB 内存的消费级机器,跑起 744B 参数的 GLM-5.2 MoE 模型。
思路是把专家参数当成流来处理:GLM-5.2 总共 744B 参数,每个 token 只用到其中约 40B,而逐 token 真正在变的路由专家约 11GB——这部分以 int4 存在磁盘上(官方推荐的 int4-g64 容器约 429GB),用到哪个换入缓存;注意力、共享专家和嵌入这些密集部分 int4 量化后常驻内存约 9.9GB。项目 2026-07-01 建仓,三个多月 GitHub 已收获 41,634 Star、4,601 Fork(2026-10-13 抓取),还带出了 Rust 复刻版等衍生项目。引擎免费开源,Apache-2.0 协议,带明确专利条款。
先把边界交代清楚:colibri 内置 13 个模型族——10 个跑语言模型(GLM-5.2 / 5.3、GLM-5.3-Flash、Inkling、Kimi K3、DeepSeek V4 Flash 与 V4.1 Flash、MiMo-V2.6 Flash、Qwen3.8-Flash-Next、Qwen3.6、OLMoE),1 个画图(Qwen-Image-2.1),2 个做判定(Laya、GLiNER2.5-Decide,另有 Clef 挂在 Qwen3.6 引擎上);本文看的是其中最大的 GLM-5.2,744B 这一档要另备约 429GB 磁盘,建议放在 NVMe 上——推理速度明显受磁盘 I/O 和缓存命中率影响。项目目前由一人维护,更新频率不定。官方对自己的一句话描述是:Tiny engine, immense model。
一条命令起步,跑起来是个本地 API
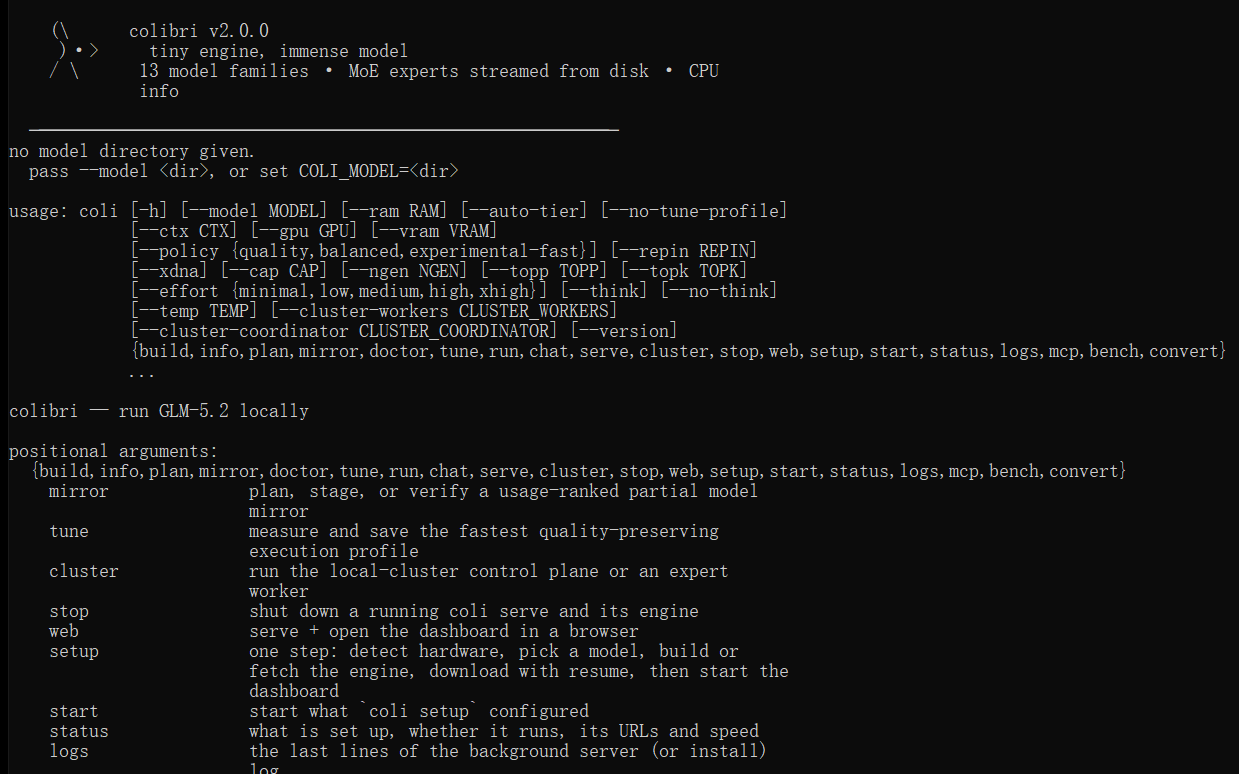
装好包后双击 coli.cmd(或直接跑同目录的 coli 脚本),第一条命令是 coli setup:它先探你的机器(内存、空闲磁盘、CPU 与 GPU),推荐一个装得下的模型,再把引擎建好或下好、断点续传地把权重拉下来,最后把 dashboard 开在浏览器里。之后 coli start 起服务、coli status 看状态与实测速度、coli logs 翻后台日志。
服务本身是 OpenAI 兼容的 HTTP 接口(coli serve);coli web 会在 API 之外再开一个网页面板;coli mcp 走 Model Context Protocol 的 stdio,给 AI 编程助手当工具用;coli cluster 则能把多台机器的专家 worker 串成一个本地集群。想先看看这台机器适合跑哪个模型,coli doctor 与 coli plan 都是只读的,不动你的盘。
MLA 加压缩 KV:一个 token 只留 576 个数
注意力这块走 GLM-5.2 原生的 MLA,再叠一层压缩 KV 缓存:每个 token 只保留 576 个 float,相比原始的 32,768 少了 57 倍,而且这份压缩状态重启后还在——同一个会话再打开,不用把之前的 prompt 重读一遍。这是 25GB 内存能装下 744B 模型的关键一环。
MTP 推测解码加 int8 内核:一次前向吐 2.2~2.8 个 token
引擎原生接 GLM-5.2 的 int8 MTP 多 token 预测头做推测解码,官方口径是「划算的时候」每次前向能出 2.2–2.8 个 token;docs/benchmarks.md 里两个实测配置的 MTP 接受率分别是 43% 和 52%。算当前专家块时,源码里还会用 WILLNEED 异步预读下一块(c/colibri.c 中 12 处)。
推测解码在冷缓存时反而更慢,赶时间可以设 DRAFT=0,或者等缓存预热再跑。固定专家想走 GPU 加速的话,Releases 里另有 Windows CUDA 专包可选,包体更小。
下载地址
| 资源 | 说明 |
|---|---|
| 官方 | GitHub Releases v2.0.0:Windows x86_64 zip 约 10.5MB / CUDA 版约 3.4MB、Linux x86_64 tar.gz 约 6.6MB、macOS arm64 tar.gz 约 3.2MB,附 SHA256SUMS.txt;亦可源码自编译(不依赖 BLAS) |
| 123云盘 | https://1626683.share.123pan.cn/123pan/ekeA-sQCw?pwd=8888# |
| 夸克 | 本轮未上传(网盘登录态失效) |
| 蓝奏 | https://ddos.lanzouc.com/iWLq74bu8r8j |
提取码统一 8888。夸克本轮登录态失效暂未上传,先用 123 云盘或蓝奏。
官网 https://justvugg.github.io/colibri | 版本 v2.0.0(2026-10-07 北京时间发布)| Windows x86_64 zip 11,019,675 字节(约 10.5MB)。模型权重需另备约 429GB 磁盘(GLM-5.2 这一档),运行约需 25GB 内存。v2.0.0 起新增 Windows CUDA 专包。
软件信息
| 项目 | 内容 |
|---|---|
| 软件名 | colibri(Colibrì) |
| 版本 | v2.0.0(GitHub Releases 最新正式版,2026-10-07 北京时间发布;此前 v1.12.1 / v1.12.0 / v1.11.0 每版均带三平台预编译包与 SHA256SUMS.txt) |
| 大小 | Windows x86_64 zip 11,019,675 字节(约 10.5MB);CUDA 版 3,549,786 字节(约 3.4MB);Linux x86_64 tar.gz 6,898,064 字节(约 6.6MB);macOS arm64 tar.gz 3,306,578 字节(约 3.2MB);GLM-5.2 权重另需约 429GB 磁盘 |
| 许可证 | Apache-2.0(含明确专利条款;仓库有 8 条公开安全公告,关联 CVE 0) |
| 平台 | Windows x86_64(普通版 / CUDA 版)、Linux x86_64、macOS arm64;源码每个模型族一个 C 文件(GLM-5.2 为 c/colibri.c,约 1.4 万行),有 C 编译器即可自编译 |
| 官方地址 | https://justvugg.github.io/colibri | https://github.com/JustVugg/colibri |