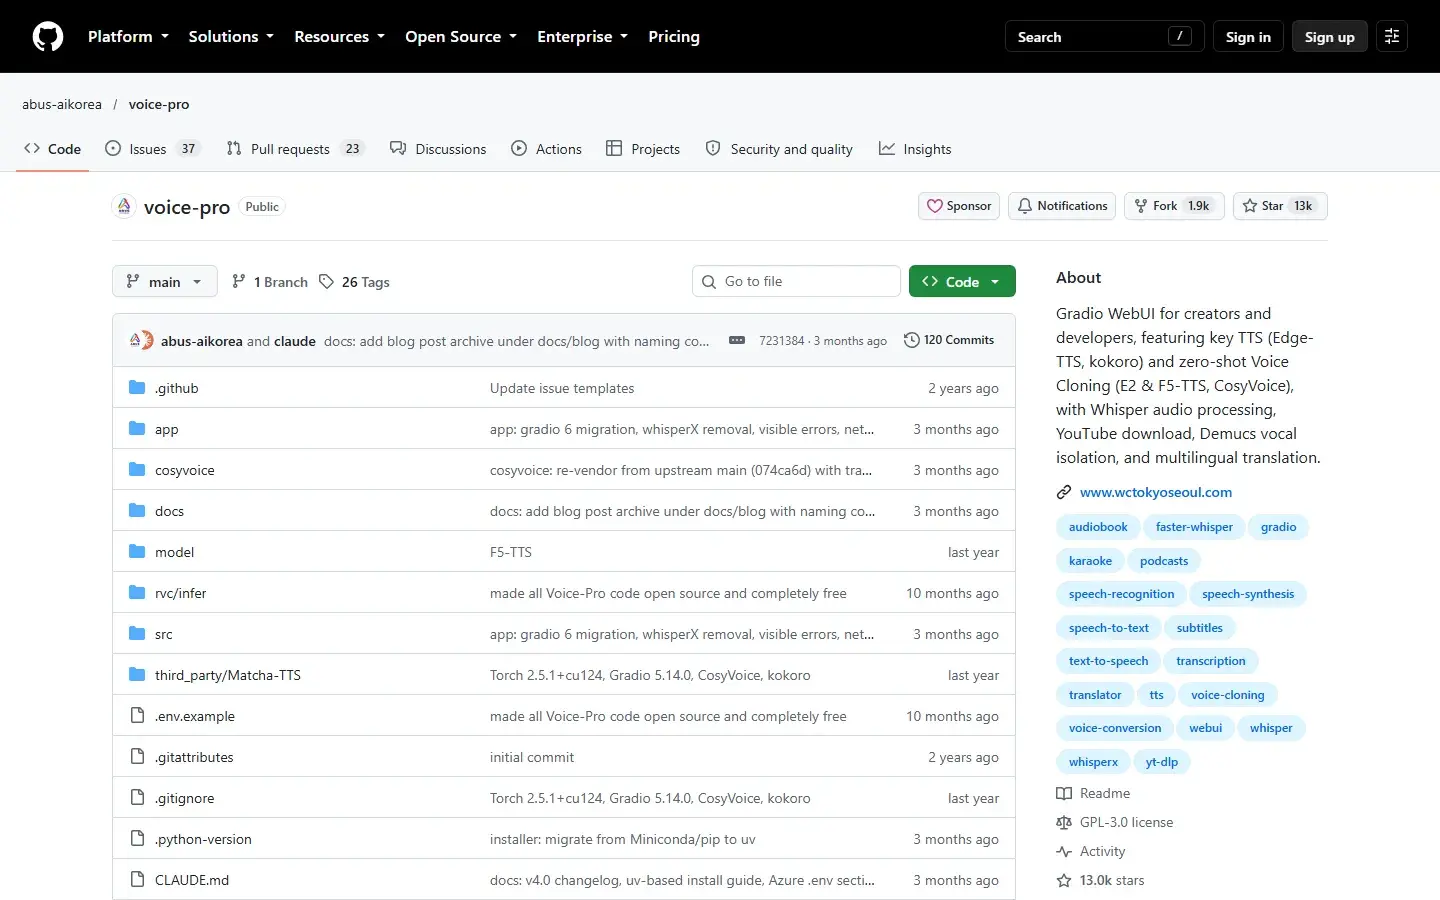
Voice-Pro 是基于 Gradio 的开源本地语音工作台:把语音识别、人声分离、字幕翻译、TTS 与零样本语音克隆塞进同一浏览器界面,适合做字幕、视频配音与多语言内容。整合 Whisper / Demucs / Edge-TTS / kokoro / F5-TTS / E2-TTS / CosyVoice。官方验证 Windows + NVIDIA;Mac / Linux 未验证。仓库 12,980 star,最新 tag v4.0.0(2026-07-13),许可 GPL-3.0。
下载地址
| 资源 | 说明 |
|---|---|
| 官方 | https://github.com/abus-aikorea/voice-pro ;源码包 https://github.com/abus-aikorea/voice-pro/archive/refs/tags/v4.0.0.zip |
| 123云盘 | 下载 |
| 夸克 | 下载 |
| 蓝奏 | 下载 |
提取码:8888
更新说明:补齐 v4.0.0 源码包(约 36.6 MB)的 123 / 夸克 / 蓝奏镜像;无二进制安装包,网盘仅为源码 ZIP。
本项目没有二进制安装包:三个 release tag(v4.0.0 / v3.2.0 / v3.1.4)都是 0 个附件,只有源码。用法是下载源码 ZIP 或 git clone 后跑 start.bat(Windows 可选跑 configure.bat 装依赖),首次启动会再拉 Whisper / Demucs / CosyVoice 等模型,需要预留 ≥20GB 磁盘、显存 4GB 起(推荐 8GB+)。
版本:v4.0.0(GitHub Releases 最新 tag,2026-07-13) 体积:源码包约数 MB;首次运行另行下载的 AI 模型以 GB 计
实测信息
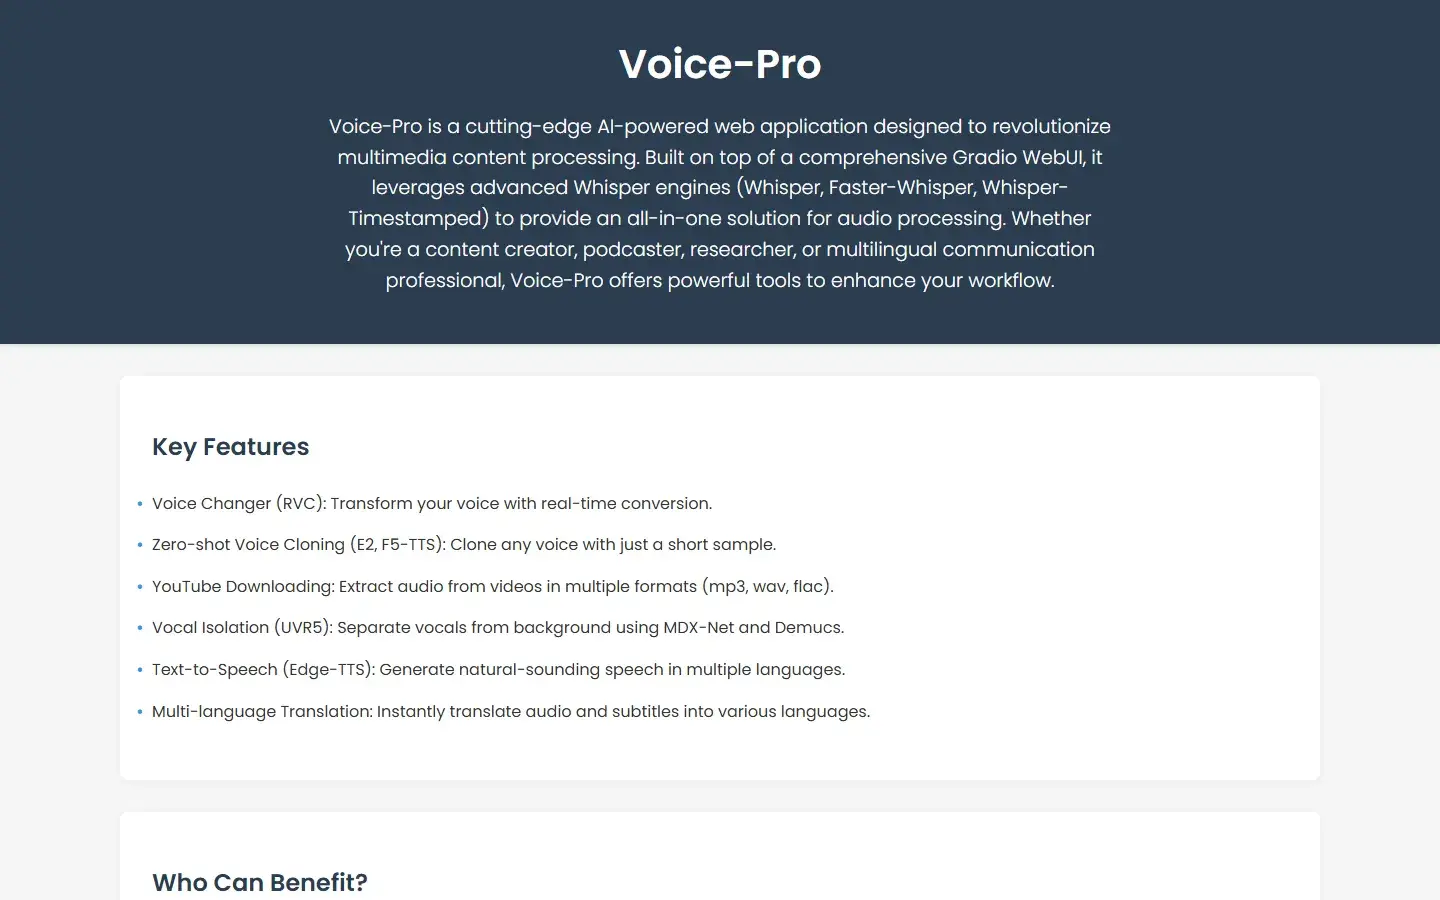
本次未在本机跑通长片全流程——Python + Gradio + CUDA 的一套依赖加 GB 级模型,不是几分钟能装完的事。下面的口径来自仓库 README、项目页与 release 清单,配图是仓库页与项目页实拍。技术栈 Python / Gradio / CUDA,官方只验证 Windows + NVIDIA。
一条龙很全,网线还是要插
Whisper 系列识别字幕;Demucs 分人声;字幕翻译与实时语音翻译;Edge-TTS、kokoro 文字转语音;F5 / E2 / CosyVoice 零样本克隆;还集成 YouTube 下载与音频提取(yt-dlp 取片)。反差在这:非完全离线——Edge-TTS、默认翻译与在线下载都要联网。可选自备 Azure Translator / TTS Key;默认走免费的 Deep-Translator + Edge-TTS。
克隆能跑,授权和显存先过关
零样本克隆把「本地版 ElevenLabs」这条叙事撑起来,但克隆需授权录音,别拿未授权素材硬套。平台门槛也别轻视:官方只验证 Windows + NVIDIA,Mac / Linux 未验证;仓库最后一次提交停在 2026-07-13,v4.0.0 之后再没发版。上手前先把磁盘和显存的账算清,短素材试跑通过再上长片。
软件信息
| 项目 | 内容 |
|---|---|
| 软件名 | Voice-Pro |
| 版本 | v4.0.0(2026-07-13,无二进制包) |
| 大小 | 源码包数 MB;模型需另留 ≥20GB |
| 许可证 | GPL-3.0 |
| 平台 | 官方验证 Windows + NVIDIA;Mac / Linux 未验证 |
| 官方地址 | https://github.com/abus-aikorea/voice-pro |
标签:Voice-Pro、语音、开源 分类:158 AI应用